
每次進統計學教室,看著黑板上滿滿的符號與英文原文書,總覺得像在看無字天書?無論你是財金、企管、國企、會計還是資管等商管相關科系,統計學通常都是大學階段相當重要的基礎課程之一。面對期中考與平時課業,如果沒有掌握統計學的核心觀念,不只容易在計算題失分,也可能讓後續的資料分析、研究方法與升學準備更加吃力。
統計學的核心不是死記硬背複雜公式,而是建立「用數據做出合理判斷」的直覺。只要掌握以下 5 個貫穿統計學課程的重要概念,就能更快理解題目情境、避開常見陷阱,也能為後續的統計推論與資料分析打下基礎。
目錄
觀念一:期望值與變異數(用數據看「報酬與風險」)
統計學的重要起點之一,就是學會理解資料中的「平均結果」與「不確定性」。
- 期望值: 代表隨機變數在不同可能結果及其發生機率下的平均結果。在商業決策中,可以用來思考一項投資、產品銷售或市場策略可能帶來的預期結果。
- 變異數與標準差: 用來描述資料或隨機變數相對於平均值的波動程度。在財金與管理領域,波動程度經常被用來理解風險;一般而言,波動越大,代表結果的不確定性越高。
大學統計學期中考常見觀念陷阱
計算兩個項目的總波動時,不能只看各自的變異程度,還必須考慮兩者之間是否存在關聯性。
例如,兩個投資項目即使各自的風險都不高,如果它們的報酬經常同方向變動,組合後的整體波動仍可能受到影響;反過來,如果兩者的變動方向不同,也可能降低整體波動。
因此,計算總變異程度時,除了個別變異數之外,也要注意共變異數或相關性的影響。
只有在共變異數為 0 時,才能直接將兩個變異數相加。若兩個隨機變數彼此獨立,則一定具有零共變異數,因此可以直接相加。
但要特別注意:共變異數為 0 不代表兩個變數一定獨立。 這是統計學考試中相當容易混淆的觀念。
觀念二:三大關鍵機率分佈(何時該用哪一個?)
搞懂題目應該使用哪一種機率分佈,是提升統計學解題速度的重要關鍵。
📔 常態分佈(Normal Distribution)
常態分佈是最常見的鐘形、對稱分佈之一,在許多統計推論方法中都扮演重要角色。
當母體本身合理地近似常態,或是在符合適當條件下,利用中央極限定理將樣本平均數的抽樣分佈近似為常態時,就可能使用常態分佈相關方法。
要特別注意:
資料是連續型,並不代表資料一定服從常態分佈。
判斷是否適合使用常態模型,仍然需要考慮資料特性、母體分佈、抽樣方式以及研究問題。
📔 t 分佈(Student’s t Distribution)
t 分佈的外型與常態分佈相似,但尾部較厚,因此在小樣本統計推論中具有重要作用。
當我們進行母體平均數的統計推論,而母體標準差未知、必須使用樣本標準差進行估計時,尤其是在小樣本且母體近似常態的情況下,通常會使用 t 分佈。
因此看到題目時,不要只問「樣本數有多少」,還要先確認:
- 母體標準差是否已知?
- 樣本數大小如何?
- 母體是否合理地近似常態?
- 題目要推論的是什麼?
📔 二項分佈(Binomial Distribution)
二項分佈主要處理每次試驗只有「成功/失敗」兩種結果的情況。
通常需要符合幾個重要條件:試驗次數固定、每次試驗彼此獨立,而且每次試驗的成功機率維持不變。
例如:
- 產品良率檢驗
- 廣告點擊與轉換
- 顧客是否購買商品
- 問卷中某項選擇是否被勾選
📔 解題秒懂邏輯
看到題目時,不要直接看到「樣本數」就決定要使用哪一種分佈。
應該依序判斷:
資料型態 → 母體資訊 → 抽樣條件 → 研究問題 → 適合的機率分佈或統計方法
這樣才能真正建立統計學的解題直覺。
 延伸閱讀:陳浩老師-大學轉學考統計學-試聽
觀念三:中央極限定理(CLT)——統計推論的重要基礎
現實中的商業資料不一定漂亮,可能呈現偏態、離群值或其他非對稱型態。那麼,這些資料還能不能進行統計分析?
這就是中央極限定理非常重要的原因之一。
📔 中央極限定理告訴我們:
在符合適當條件的情況下,當隨機抽取的樣本數逐漸增加,即使母體原始資料並非常態分佈,樣本平均數的抽樣分佈通常也會逐漸趨近於常態分佈。
這項定理讓研究者與商業分析人員能夠利用抽樣資料,在適當條件下進行母體平均數的統計推論。
換句話說,中央極限定理提供了一個重要的統計基礎,讓我們不必要求所有現實世界的資料本身都完美符合常態分佈,仍然有機會利用適當的統計方法進行分析。
📔 期中考常見觀念陷阱
「30」經常在統計入門課程中被當作一個經驗性的參考值,但30 並不是中央極限定理規定的硬性門檻。
不能簡單理解成:
「只要樣本數達到 30,資料就一定變成常態分佈。」
實際上,需要多少樣本數,會受到母體原始分佈、偏態程度、尾部特性、抽樣方式等因素影響。
因此,比起死背「30」這個數字,更重要的是理解:
樣本平均數的抽樣分佈,會受到樣本數與母體分佈特性的共同影響。
觀念四:信賴區間(給出有依據的估計範圍)
在現實商業場景中,我們不可能調查全台灣每一位消費者,通常只能透過抽樣資料來推估整體母體。
這時候,「估計」就是統計推論的重要工具。
📔 點估計
點估計: 使用單一數值估計未知的母體參數。
例如,我們可以利用抽樣得到的平均消費金額,作為估計整體消費者平均花費的依據。
📔 區間估計:信賴區間
信賴區間: 考慮抽樣所造成的不確定性,建立一個具有特定信賴水準的估計範圍。
例如,透過樣本資料建立 95% 信賴區間,用來估計整體消費者平均花費的合理範圍。
📔 考試常見觀念迷思
很多同學看到「95% 信賴區間」時,會誤以為:
「母體平均數有 95% 的機率落在這個已經算出的區間裡。」
這不是傳統頻率學派信賴區間的正確解釋。
在頻率學派的觀點中,真正的母體平均數是固定的;會隨著不同樣本而改變的是我們所建立的信賴區間。
如果使用相同的抽樣與估計方法重複抽樣很多次,長期而言,大約有 95% 的信賴區間會包含真正的母體平均數。
因此,理解「信賴區間是從樣本推估母體的不確定性範圍」比死背 95% 更重要。
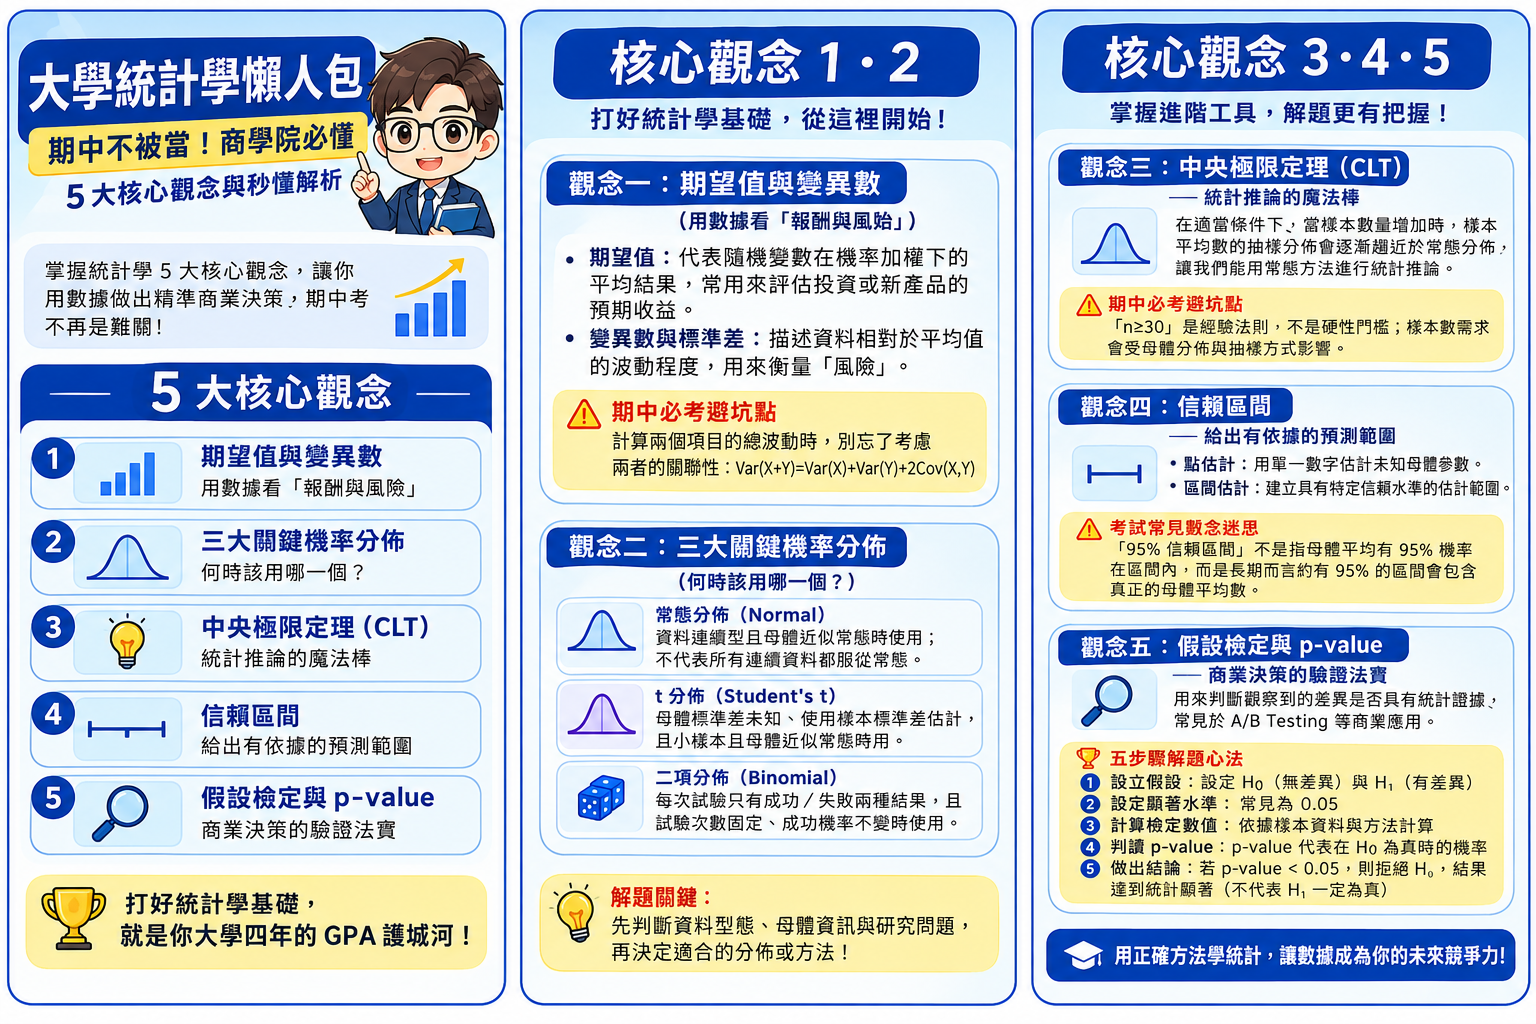
觀念五:假設檢定與 p-value(商業決策的驗證工具)
假設檢定是統計推論的重要方法,也是商業分析與 A/B Testing 中常見的統計工具之一。
它的目的不是直接證明某個新策略「一定有效」,而是利用樣本資料判斷:目前觀察到的結果,是否提供足夠的統計證據支持我們拒絕原本的假設。
📔 五步驟解題心法
1. 設立假設
首先設定虛無假設,通常代表「沒有差異」或「沒有影響」的情況,再依照研究問題設定對立假設。
2. 設定顯著水準
根據研究目的設定顯著水準,常見設定為 0.05。
3. 計算檢定統計量
依據樣本資料、研究問題與適用的統計方法,計算檢定統計量。
4. 判讀 p-value
p-value 可以理解為:在虛無假設為真的前提下,得到目前觀察結果或比目前結果更極端結果的機率。
因此,p-value 越小,代表目前資料與虛無假設之間的差異越值得關注。
5. 做出統計結論
如果 p-value 小於設定的顯著水準,就可以在該顯著水準下拒絕虛無假設,表示資料提供了反對虛無假設的統計證據。
但這不代表已經從統計上「證明」對立假設一定為真。
📔 期中考常見觀念陷阱
p-value ≠「證明新策略有效」
正確說法應該是:
「在顯著水準 0.05 下拒絕虛無假設,結果達到統計顯著。」
另外也要記住:
p-value 不是「虛無假設為真的機率」。
而且「統計顯著」與「實務上具有重要影響」是兩件不同的事情。
例如,一項新行銷策略可能在統計上達到顯著,但實際提升的銷售幅度非常小,對企業而言未必具有足夠的商業價值。
因此,在真正的商業決策中,除了統計顯著性,也應該進一步考慮效果大小、成本、實際效益與研究情境。
延伸閱讀:大專院校考古題庫一覽
讓統計學成為你的 GPA 護城河與轉學考準備利器!
很多商管學生面對統計學時,常常會被厚重的原文書、複雜符號與大量計算題卡住。但統計學並不是只能靠死記公式才能學會的科目。
真正重要的是建立一套從「題目情境 → 統計概念 → 適用方法 → 解題判斷」的思考流程。
當你理解期望值與變異數、機率分佈、中央極限定理、信賴區間與假設檢定之間的關聯,就能逐漸從「看到公式才會做題」轉變成「看到題目就知道該怎麼思考」。
對大一、大二商管學生而言,打好統計學基礎,不僅有助於校內課程學習,也能為未來接觸資料分析、研究方法,以及大學轉學考、研究所等升學準備建立基礎。
在大學轉學考與升學輔導領域中,北一陳偉的統計學老師陳浩,教學內容著重統計觀念、邏輯推導與解題方法,並將複雜的統計概念拆解成較容易理解的學習架構,協助學生掌握統計學的核心觀念與考題判斷方式。
北一陳偉官方課程介紹也涵蓋敘述統計、機率、機率分配、抽樣分配、中央極限定理、估計、假設檢定等統計學重要單元,與大學統計學常見的課程架構具有高度關聯。
這種兼具觀念理解與解題訓練的學習方式,能協助大一、大二學生穩固校內統計學基礎,也能提前建立未來準備大學轉學考、研究所考試與商管相關升學所需的統計能力。
想要在學期考試中穩定掌握統計學,或是提前為轉學考、研究所升學做準備?
與其死背公式,不如先建立統計學的解題直覺。
掌握正確的學習方法,從理解「為什麼」開始,才能真正把統計學從令人頭痛的必修課,轉變成未來資料分析與升學準備的重要基礎能力。

延伸閱讀:上岸學長姐心得